AIDC 設計
場地、電力與冷卻架構
Flagship Project | 旗艦專案 · 馬來西亞賽城
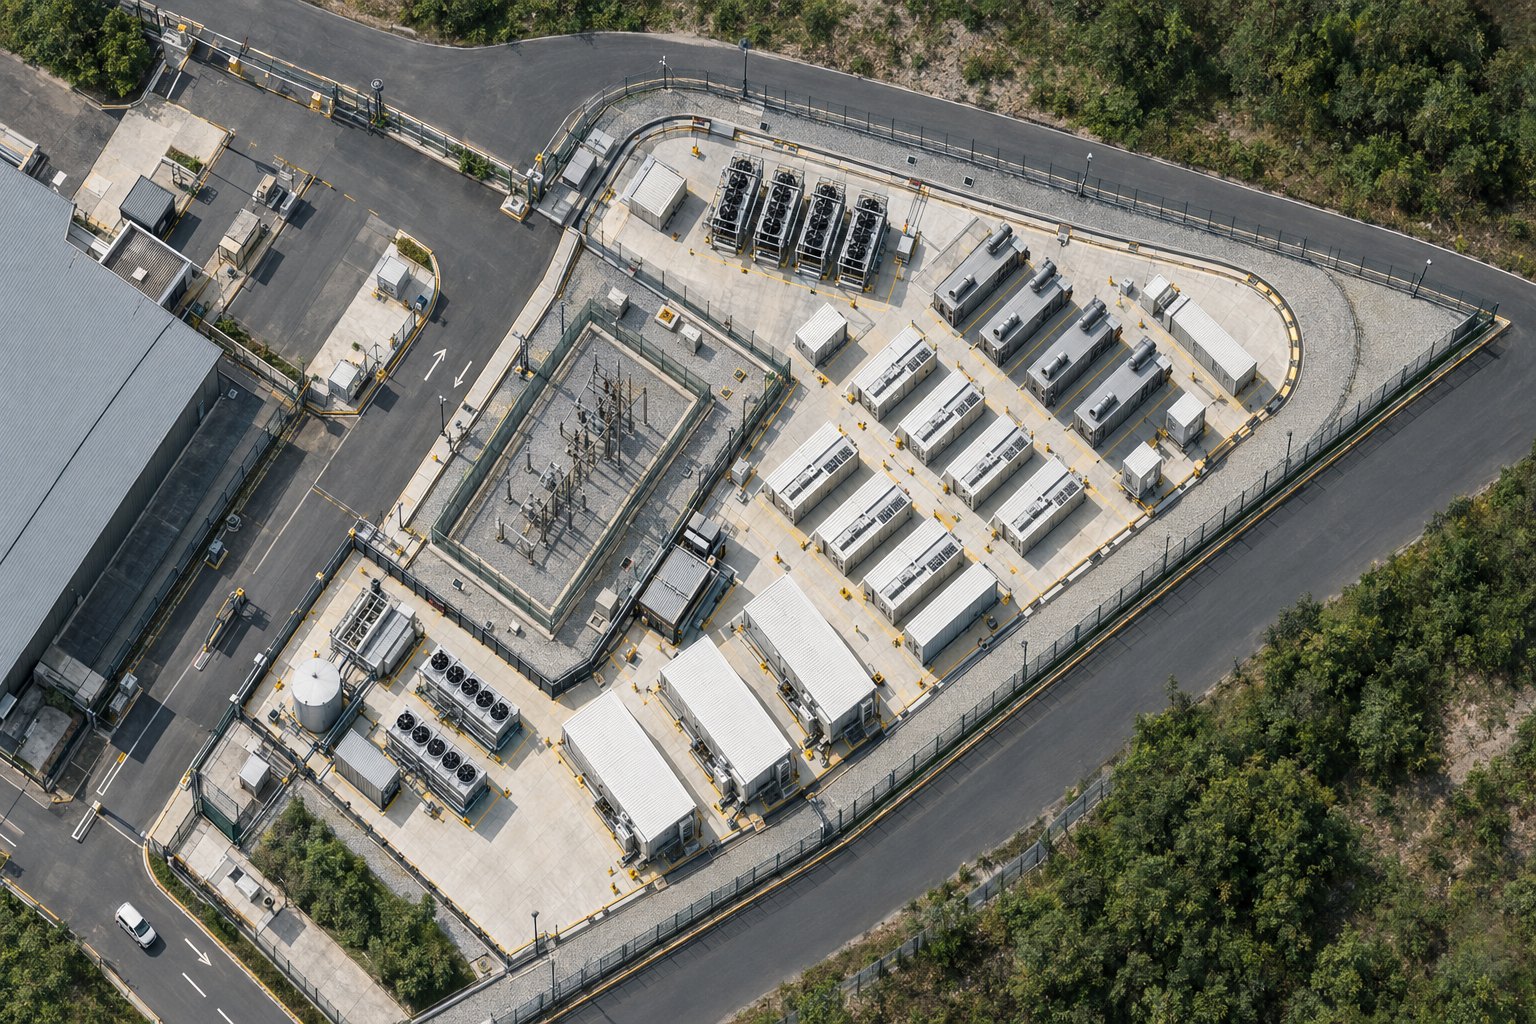
KONST Group(康斯特超算集團)與威剛科技(ADATA)合作,於馬來西亞賽城自營 1,024 顆 B300 GPU 叢集,以裸機(Bare Metal)形式對外提供算力服務。
KONST 在本案同時掌握場地容量與 GPU 叢集,從 AIDC 設計、電力與容量規劃、GPU 採購、上架部署、效能驗證到叢集維運,由同一個團隊端到端負責。
叢集以裸機形式交付,客戶取得作業系統 root 權限與帶外管理權限,排程層與軟體堆疊自主決定;叢集為客戶物理獨佔,不與其他租戶共用機櫃或運算資源。
多數算力案子只能介入其中一段:做完 AIDC 就停,或從別人手上接現成叢集再轉售。本案六個階段全部由 KONST 負責。
場地、電力與冷卻架構
2,061 kW 契約容量配置
131 台 B300 液冷節點
機櫃佈線與液冷接管
CFD 熱流模擬與 NCCL 頻寬驗證
24×7 監控與現場駐點
* 生產 GPU 數量為 128 台 × 8 卡,合計 1,024 顆;熱備援 3 台(24 卡)不計入生產容量。實際配置以雙方簽署之訂單為準。
以 NVIDIA HGX B300 八卡液冷平台為單一節點,128 台構成生產叢集,另配 3 台熱備援。
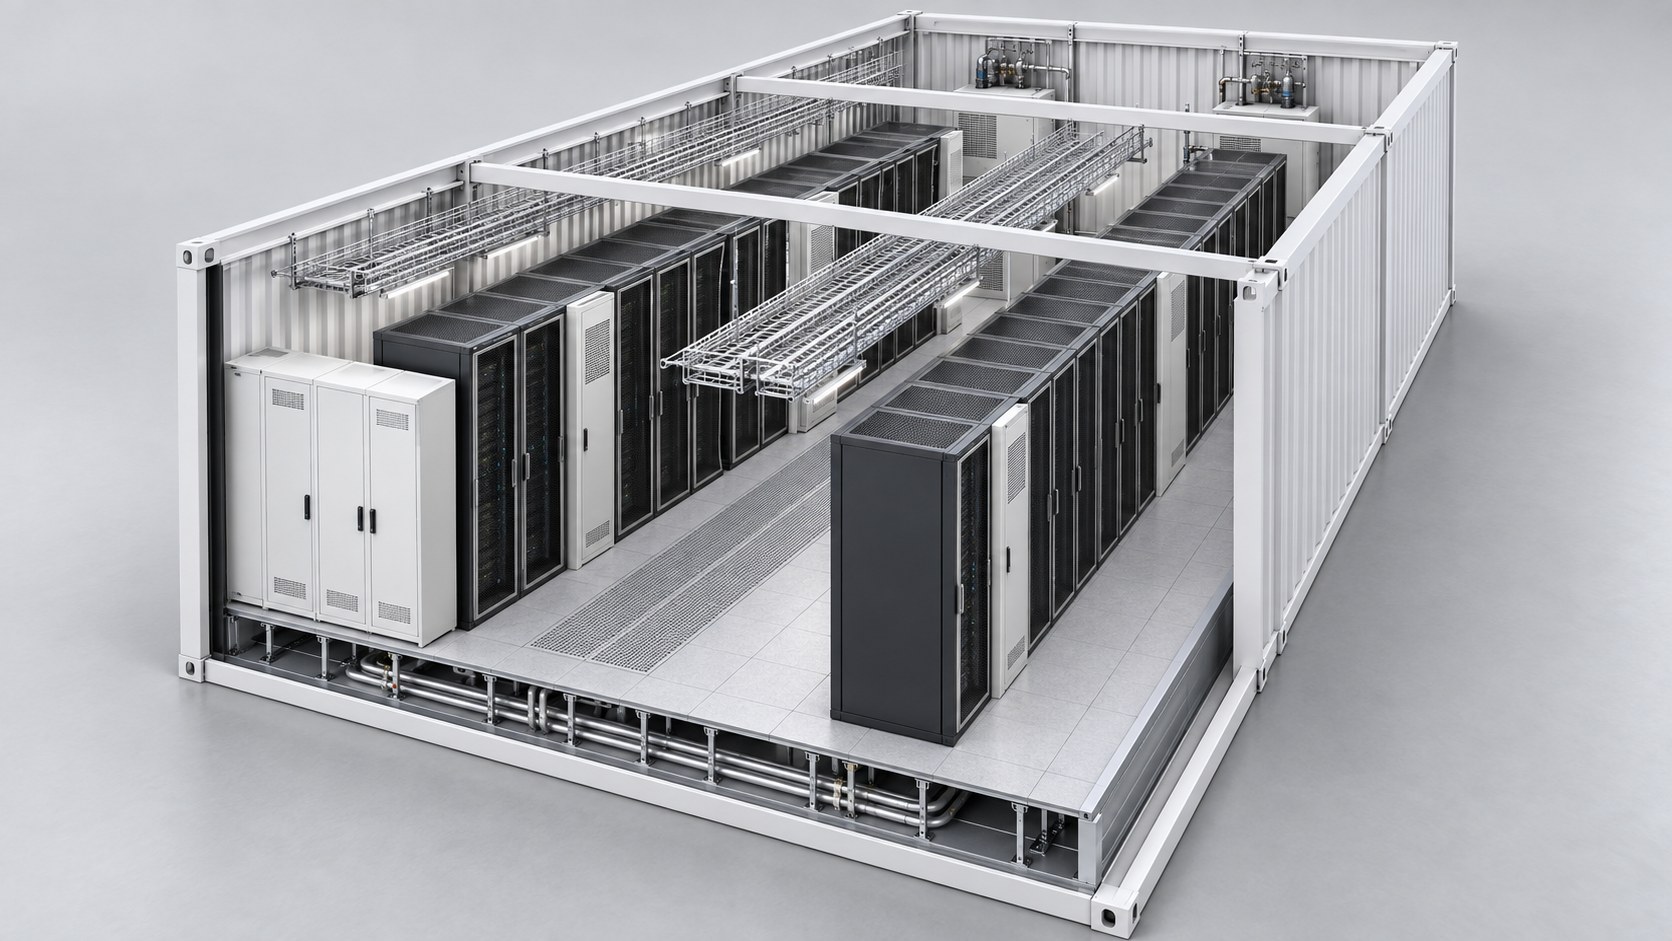
賽城案場採預製貨櫃模組式 AI 資料中心。模組於工廠完成整合並通過出廠驗收後運抵現場吊裝,場地基建先行到位,叢集可直接以帶電狀態交付。IT pod 為單一租戶專用,不與其他租戶共用。
| GPU 節點 | NVIDIA HGX B300 八卡液冷平台(NVL8 形態),共 131 台;128 台生產配置與 3 台熱備援 |
| GPU 總數 | 1,024 顆(128 台 × 8 卡)* |
| 節點處理器 | 2 × Intel Xeon 6776P,64 核、2.3 GHz、350 W |
| 節點記憶體 | 3 TB DDR5 RDIMM 6400 MHz |
| 節點本地儲存 | 8 × 3.84 TB Gen5 NVMe(2.5 吋),另 2 × 960 GB M.2 供作業系統使用 |
| 節點網卡 | NVIDIA ConnectX-8 SuperNIC,相容 BlueField-3 DPU |
| 管理節點 | 12 台 AMD EPYC 9334,32 核、2.7 GHz;ConnectX-7 200 G × 2 |
| 機櫃配置 | 25 座:17 座 GPU 櫃(16 座滿載 × 8 台,1 座熱備援 × 3 台)與 8 座網路管理櫃 |
| 共享儲存 | 容量與聚合頻寬依客戶需求配置,另行規劃 |
| 計算網路 | InfiniBand,每節點 8 × 800 Gb/s OSFP XDR,經 NVIDIA ConnectX-8 SuperNIC 提供 |
| 組網架構 | 1:1 無阻塞(non-blocking)Spine-Leaf;交換機型號依最終配置確認 |
| GPU 間互聯 | NVLink 與 NVLink Switch,單域 8 顆 GPU,GPU 對 GPU 1.8 TB/s |
| GPUDirect RDMA | 支援;節點間 RDMA 屬叢集內部流量,不另計費 |
| 儲存網路 | 獨立組網 200 GbE,透過骨幹連接,不與計算網複用 |
| 管理網路 | 獨立網段,提供帶外管理(BMC/IPMI)存取 |
| 網路隔離 | 計算、儲存、管理三網分離;叢集為單一租戶專用,不與其他租戶共用 |
| 對外連線 | 2 × 10G 雙鏈路,分屬不同營運商與不同路由互為備援;支援專線(EPL)與 VPN 接入 |
| 連線交接 | 對外連線交接至 MMR 之 patch panel,櫃內跳接由 KONST 負責 |
| 位置 | 馬來西亞雪蘭莪州賽城(Cyberjaya, Selangor, Malaysia) |
| 建置形式 | 預製貨櫃模組式 AI 資料中心;單一租戶專用之 IT container pod |
| 機房等級 | Tier III 設計標準 |
| 契約容量 | 2,061 kW,其中 2,016 kW 為計費基準,45 kW 為熱備援,兩者分列* |
| 電力架構 | 11 kV 雙路市電(dual-feeder)與主開關站、變壓器;UPS 與發電機備援 |
| 冷卻架構 | CPU 與 GPU 晶片級直接液冷(DLC)並配置漏液偵測;機櫃層級殘熱由列間氣流系統處理 |
| 熱流驗證 | 已完成 CFD 熱流模擬,合格標準為機櫃進風溫度 27 °C 以下,模擬結果全數符合 |
| 實體安全 | 園區與資料中心兩層圍籬、CCTV 與感測器全套配置、門禁管制與 24×7 監控 |
| 環境條件 | 溫濕度全時監控;環控與消防系統依資料中心標準配置 |
| 交付形式 | 裸機(Bare Metal)交付。客戶取得作業系統 root 權限;BMC 與 IPMI 帶外管理權限之開放範圍載明於訂單 |
| 資源獨佔 | 叢集為客戶物理獨佔,不與其他租戶共用機櫃或運算資源 |
| 場地維運 | 資料中心營運方負責設施維運,人員 24 小時駐場 |
| 叢集維運 | KONST 自派 GPU 維運人員現場駐點,負責 GPU 節點、網路與硬體層 |
| 熱備援 | 配置 3 台熱備援節點,節點故障時遞補,並依原廠 RMA 程序處理 |
| 備品 | 備品存放於馬來西亞現場 |
| 監控與報告 | 提供節點、儲存與 GPU 層級即時監控指標與月度可用率報告 |
| 計劃維護 | 提前 7 天通知;GPU 驅動更新採排程方式,於確認客戶需求後約定時間執行 |
| 驗收指標 | 可納入 NCCL all-reduce 頻寬、NVLink 頻寬、GEMM 吞吐、HBM 頻寬、儲存 IOPS 與燒機測試 |
| 服務等級 | 叢集可用率與分級事故回應條件依算力服務主約(MSA)與訂單約定 |
* 生產 GPU 數量為 128 台 × 8 卡,合計 1,024 顆;熱備援 3 台不計入生產容量。場地設計參數依現行設計版本,設計凍結後如有調整將另行更新。
計算網採 InfiniBand 1:1 無阻塞架構;儲存網獨立組網,不與計算網複用。
每節點 8 × 800 Gb/s OSFP XDR,Spine-Leaf 架構,可依客戶要求納入 NCCL all-reduce 頻寬基線作為驗收指標。
200 GbE 透過骨幹連接,不與計算網複用,避免儲存流量佔用訓練所需的東西向頻寬。
提供 BMC 與 IPMI 帶外管理存取,開放範圍載明於訂單。
大規模分散式訓練的瓶頸通常不在單卡算力,而在 all-reduce 階段的東西向頻寬。收斂比一旦大於 1:1,梯度同步會隨節點數增加而惡化。本叢集自設計階段即採 1:1 無阻塞。
場地與設施維運由威剛科技(ADATA)負責,GPU 叢集由 KONST 自營並派駐維運人員。
場地與設施維運由威剛科技負責,人員 24 小時駐場;GPU 叢集由 KONST 自營,並自派維運人員現場駐點。兩段維運分工,責任界面載明於算力服務主約。
由資料中心營運方負責,涵蓋場地、電力、冷卻與實體安全,人員 24 小時駐場處理設施層事件。
由 KONST 自派人員負責,涵蓋 GPU 節點、網路與硬體層,僅 KONST 維運人員具白區門禁權限。
貨櫃模組已進入工廠整合,叢集依現行建置排程推進,與商務洽談平行進行。
2026 年 11 月
2026 年 12 月
2027 年 1 月
2027 年 1 至 2 月
2027 年 3 月
* 上表為現階段建置排程之工作預估,供評估參考;具合約拘束力之交付日期,以雙方簽署之合約所載之約定交付日為準。
客戶取得作業系統 root 權限;叢集為客戶物理獨佔,不與其他租戶共用機櫃或運算資源。
* 責任界面之最終範圍依雙方簽署之算力服務主約(MSA)與訂單(Order Form)為準。
FAQ| 常見問題
依 2026 年 9 月的專案條件回答。
生產叢集為 128 台 NVIDIA HGX B300 八卡液冷節點,合計 1,024 顆 GPU,另配置 3 台熱備援節點與 12 台管理節點,分布於 25 座機櫃。契約容量 2,061 kW。單一節點配置 2 顆 Intel Xeon 6776P、3 TB DDR5 記憶體與 8 顆 3.84 TB Gen5 NVMe。
計算網採 InfiniBand,每節點 8 條 800 Gb/s OSFP XDR,經 NVIDIA ConnectX-8 SuperNIC 提供,組網為 1:1 無阻塞 Spine-Leaf。節點內以 NVLink 與 NVLink Switch 互聯,單域 8 顆 GPU 之間為 1.8 TB/s。儲存網獨立組網 200 GbE,管理網為獨立網段,三網彼此分離不複用。
大規模分散式訓練的瓶頸通常不在單卡算力,而在 all-reduce 階段的東西向頻寬。收斂比一旦大於 1:1,梯度同步會隨節點數增加而惡化。本叢集自設計階段即採 1:1 無阻塞,並可依客戶要求納入 NCCL all-reduce 頻寬基線作為驗收指標。
裸機(Bare Metal)交付。客戶取得作業系統 root 權限,BMC 與 IPMI 帶外管理權限之開放範圍載明於訂單。排程層與軟體堆疊由客戶自主決定。叢集為客戶物理獨佔,不與其他租戶共用機櫃或運算資源。
叢集配置 3 台熱備援節點,節點故障時遞補,並依原廠 RMA 程序處理,備品存放於馬來西亞現場。維運分為兩段:場地與設施由資料中心營運方負責,人員 24 小時駐場;GPU 節點、網路與硬體層由 KONST 自派維運人員現場駐點。叢集可用率與分級事故回應條件依算力服務主約與訂單約定。
以 GPU 使用時數為計價基礎,按月收取算力服務費,標準合約期間為 5 年,5 年以下依規模與條件另議。簽約後支付履約押金,並於服務期內依約抵充。計費自客戶書面確認驗收合格之服務啟用日起算,非以設備交付日為準。網路連線、共享儲存、受管編排與效能驗證另行報價。實際費率請聯繫業務團隊。
叢集建置已啟動,與商務洽談平行進行,不因簽約時點而改變排程。貨櫃模組於 2026 年 11 月完成工廠整合與出廠驗收,2026 年 12 月首批模組到場,2027 年 1 月吊裝與機電接駁,2027 年 1 至 2 月上架與叢集調測,預計 2027 年 3 月完成 POC 與驗收上線。洽談到簽約約需一個月。